
Situatie
Atunci când rulezi microservicii într-un cluster Kubernetes, o problemă frecventă întâlnită în medille de producție este apariția erorilor de tip OOMKilled (Out Of Memory) urmate de starea CrashLoopBackOff. Această situație apare de obicei atunci când cererea de memorie depășește limitele setate sau aplicația are scurgeri de memorie nerezolvate.
Solutie
- Identificarea cauzei exacte prin comenzi de diagnostic: Rulează următoarea comandă pentru a vedea istoricul recent al pod-ului și motivul exact al ultimului crash:
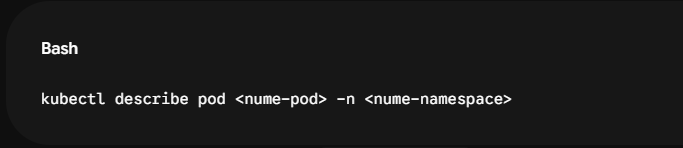
Caută în secțiunea Last State câmpulOOMKilled: truesau un cod de ieșire diferit de zero (Exit Code: 137), care indică faptul că procesul a fost ucis forțat de kernel din cauza depășirii limitei de RAM.-
Ajustarea resurselor în fișierul de configurare (Deployment YAML): Mărește limitele de memorie (
limits) și ajustează resursele garantate (requests) în fișierul de manifest al deployment-ului: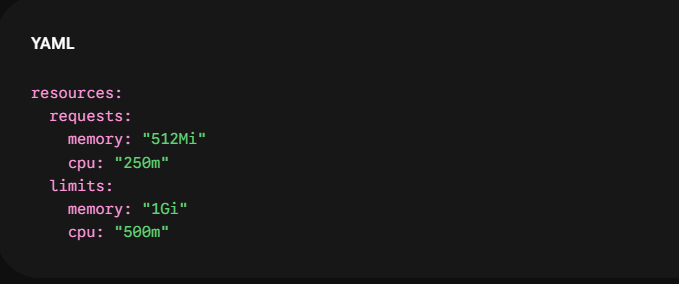
3. Configurarea corectă a sondelor de sănătate (Probes): Dacă aplicația are nevoie de mai mult timp pentru a porni, o sondă de pregătire sau de viață (
livenessProbe) configurată greșit poate forța Kubernetes să restarteze containerul prematur. Mărește valoareainitialDelaySecondsșifailureThreshold: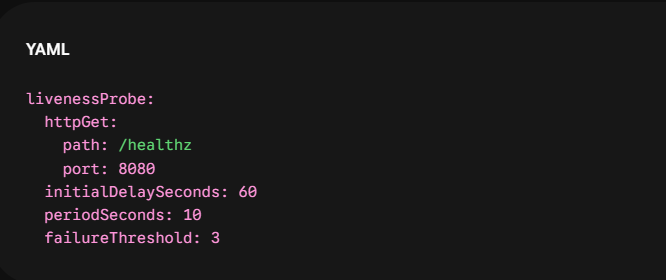
Leave A Comment?